In diesem Artikel erfahren Sie, wie Sie nach dem dauerhaften Ausfall von zwei Knoten in einem 3-Node-Proxmox-VE-Cluster mit Ceph HCI ein vollständiges Disaster Recovery durchführen und den Cluster mit neuen Nodes wieder in einen redundanten, gesunden Zustand (HEALTH_OK) überführen.
Versionskompatibilität: Dieser Guide wurde unter Proxmox VE 8 und Ceph 18.2.4 erarbeitet – die Wiederherstellungsschritte und CLI-Befehle sind unter Proxmox VE 9 und Ceph 20.2.4 vollständig identisch und unverändert gültig.
Inhaltsverzeichnis
- Ausgangslage
- Disaster & Systemverhalten
- Schritt 1: Corosync Quorum auf dem verbleibenden Node wiederherstellen
- Schritt 2: Neue Proxmox VE Nodes zum Cluster hinzufügen
- Schritt 3: Ceph Monitor Quorum manuell erzwingen (Monmap Recovery)
- Schritt 4: Verwaiste OSDs der ausgefallenen Nodes entfernen
- Schritt 5: Ceph-Dienste auf den neuen Nodes aufbauen
- Schritt 6: Verifikation des Gesamtsystems
- Fazit & Best Practices
Ausgangslage
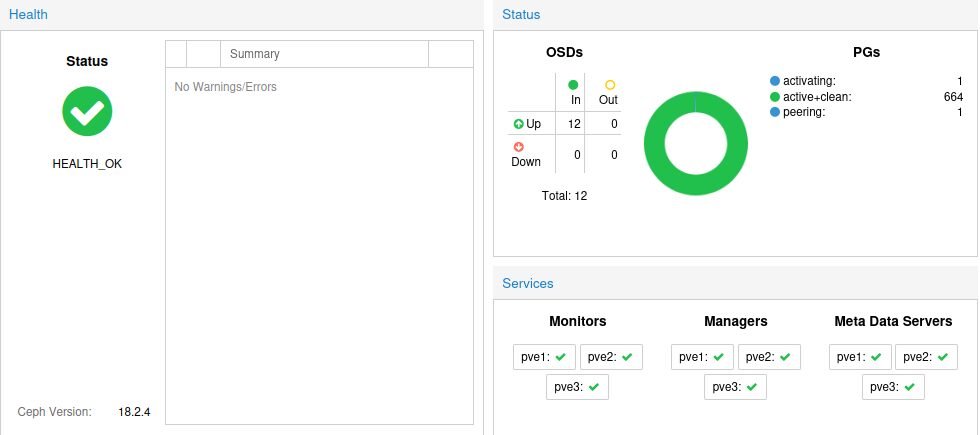
Das Testing und Szenario beginnt mit einem vollständig gesunden 3-Node Proxmox VE Ceph HCI Cluster (Nodes: pve1, pve2, pve3). Die Konfiguration umfasst:
- Ceph-Dienste: 3x MON, 3x MGR und 3x MDS (für CephFS)
- Pools: NVMe-Pool (
vm_nvme) sowie CephFS-Pools (cephfs_dataundcephfs_metadata) - Workloads: Produktive VMs (z. B. VM 100 mit dem Namen
debian-1) - Gesamt-Status: 12 OSDs (alle
upundin), 664 Placement Groups im Statusactive+clean,HEALTH_OK.
Disaster & Systemverhalten
Zwei der drei Knoten (pve2 und pve3) fallen zeitgleich und irreversibel aus (z. B. hardwareseitiger Totalausfall). Lediglich der Knoten pve1 bleibt betriebsbereit.
Verhalten nach dem Ausfall von 2 der 3 Nodes
Durch den plötzlichen Verlust von zwei Dritteln der Cluster-Stimmen treten gravierende Blockaden ein:
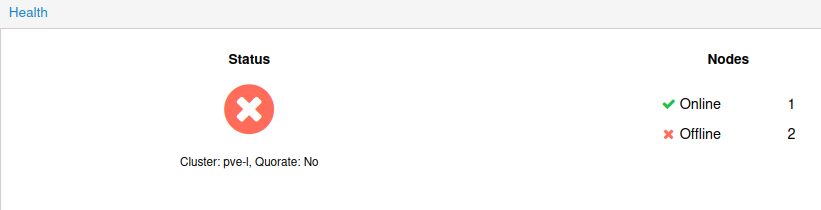
- Quorum-Verlust im Proxmox VE Cluster (Corosync): Das Cluster verliert sein Quorum (
Quorate: No). Das Proxmox Cluster Filesystem (pmxcfs) wird in den Read-Only-Modus versetzt; Konfigurationsänderungen sind blockiert. - Ceph Storage-Quorum-Verlust: Ceph benötigt für die Monitore eine Mehrheit (bei 3 Monitoren mindestens 2). Da nur noch 1 Monitor online ist, verliert Ceph das Quorum und stoppt sofort alle I/O-Zugriffe zum Schutz vor Dateninkonsistenzen (I/O-Freeze).
- Ausfall laufender VMs & Node-Neustart: Durch den Storage-Freeze funktionieren auch laufende VMs nicht mehr und hängen fest. Bei aktiviertem HA führt der Quorum-Verlust zudem zu einem automatischen Fencing/Neustart des verbleibenden Nodes (Watchdog-Reset) – nach dem Reboot bleiben sämtliche VMs offline, da ohne Quorum kein Start möglich ist.
- Web-GUI & CLI blockiert: Die Ceph-Verwaltung in der Proxmox Web-UI lädt nicht mehr (Timeouts), und CLI-Befehle wie
ceph osd treeoderceph -shängen ohne Rückmeldung fest.
Schritt 1: Corosync Quorum auf dem verbleibenden Node wiederherstellen
Damit Proxmox VE auf pve1 wieder handlungsfähig wird, muss dem Cluster mitgeteilt werden, dass vorübergehend eine einzige Stimme für das Quorum genügt (pvecm expected 1). Anschließend werden die nicht mehr existenten Nodes sauber aus dem Cluster gelöscht.
Führen Sie auf der Root-Shell von pve1 folgenden Befehl aus:
root@pve1:~# pvecm expected 1Entfernen Sie nun nacheinander die beiden ausgefallenen Knoten:
root@pve1:~# pvecm delnode pve2
Could not kill node (error = CS_ERR_NOT_EXIST)
Killing node 2

root@pve1:~# pvecm expected 1

root@pve1:~# pvecm delnode pve3
trying to acquire cfs lock 'file-corosync_conf' ...
trying to acquire cfs lock 'file-corosync_conf' ...
Could not kill node (error = CS_ERR_NOT_EXIST)
Killing node 3pve3 die Meldung trying to acquire cfs lock 'file-corosync_conf' erscheint, wiederholen Sie den Befehl nach kurzer Pause. Sobald Killing node 3 ausgegeben wird, ist der Vorgang abgeschlossen.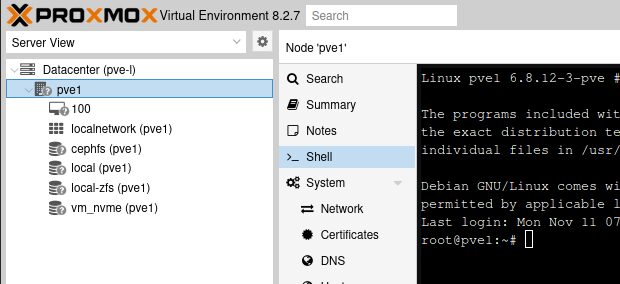
Schritt 2: Neue Proxmox VE Nodes zum Cluster hinzufügen
Bereiten Sie zwei neue Server vor (in unserem Beispiel: pve4 und pve-5 mit neuen IP-Adressen und Hostnamen). Treten Sie dem bestehenden Cluster bei:
- In der Web-GUI von
pve1unter Datacenter → Cluster → Join Information die Cluster-Join-Informationen kopieren. - Auf
pve4undpve-5jeweils über Datacenter → Cluster → Join Cluster beitreten.
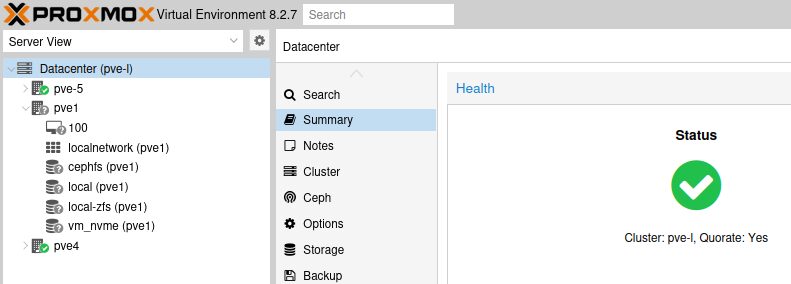
Nach dem Beitritt ist das Proxmox VE Cluster wieder vollständig quorate (Quorate: Yes).
Schritt 3: Ceph Monitor Quorum manuell erzwingen (Monmap Recovery)
Obwohl Proxmox VE wieder über Quorum verfügt, bleibt Ceph blockiert: Die Ceph-Monmap erwartet weiterhin 3 Monitore, wovon 2 offline sind. Da Befehle wie pveceph mon destroy ohne bestehendes Ceph-Quorum fehlschlagen, muss die Monmap auf Dateiebene manuell bereinigt werden.
1. Ceph-Monitor auf pve1 stoppen
root@pve1:~# systemctl stop ceph-mon@pve1.service2. Monmap extrahieren
root@pve1:~# ceph-mon -i pve1 --extract-monmap /tmp/monmap3. Monmap anzeigen und analysieren
root@pve1:~# monmaptool /tmp/monmap --printDie Ausgabe zeigt alle 3 registrierten Monitore:
monmaptool: monmap file /tmp/monmap
epoch 3
fsid 506415a5-936e-47e7-9e2d-9c934f447407
min_mon_release 18 (reef)
election_strategy: 1
0: [v2:192.170.130.10:3300/0,v1:192.170.130.10:6789/0] mon.pve1
1: [v2:192.170.130.11:3300/0,v1:192.170.130.11:6789/0] mon.pve2
2: [v2:192.170.130.12:3300/0,v1:192.170.130.12:6789/0] mon.pve3
4. Alte Monitor-Einträge entfernen (pve2 und pve3)
root@pve1:~# monmaptool /tmp/monmap --rm pve2
root@pve1:~# monmaptool /tmp/monmap --rm pve3
5. Bereinigte Monmap verifizieren und einspielen
root@pve1:~# monmaptool /tmp/monmap --print
root@pve1:~# ceph-mon -i pve1 --inject-monmap /tmp/monmap
6. Ceph-Monitor wieder starten
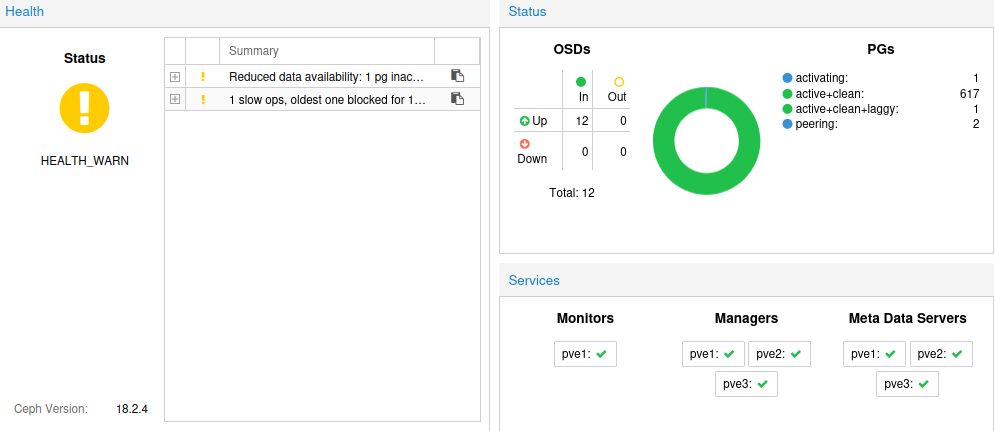
root@pve1:~# systemctl start ceph-mon@pve1Ceph verfügt nun über ein aktives 1-Node-Monitor-Quorum. Das Dashboard und alle CLI-Tools reagieren sofort wieder:
Status der Begleitdienste:
- Ceph MGR: Keine Aktion erforderlich (läuft auf
pve1weiter). - Ceph MDS: Keine Aktion erforderlich (bei Standard-Konfiguration mit 1 aktiven MDS).
Schritt 4: Verwaiste OSDs der ausgefallenen Nodes entfernen
Die OSDs der zerstörten Server pve2 und pve3 existieren physisch nicht mehr und müssen sauber aus der CRUSH-Map und dem Ceph-Keyring entfernt werden.
ceph osd tree absolut sicher, dass Sie unter keinen Umständen die noch gesunden OSDs von pve1 (hier OSD 0 bis 3) entfernen!Prüfen Sie die OSD-Struktur:
root@pve1:~# ceph osd treeEntfernen Sie die verwaisten OSDs (im Beispiel: OSD 4 bis 11) mit folgender Schleife:
root@pve1:~# for osd in {4,5,6,7,8,9,10,11}; do
  ceph osd down osd.$osd &&
  ceph osd out osd.$osd &&
  ceph osd crush remove osd.$osd &&
  ceph auth del osd.$osd &&
  ceph osd rm osd.$osd;
done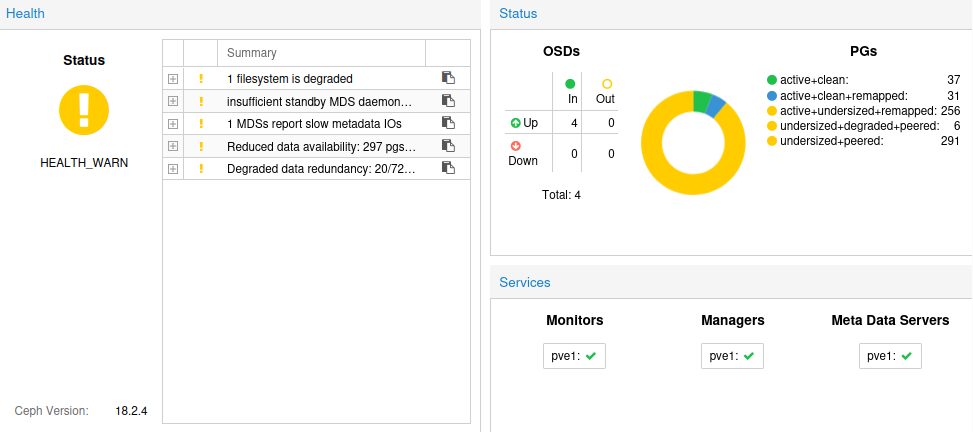
Schritt 5: Ceph-Dienste auf den neuen Nodes aufbauen
Integrieren Sie nun die beiden neuen Knoten pve4 und pve-5 in Ceph:
1. Ceph-Monitore erstellen
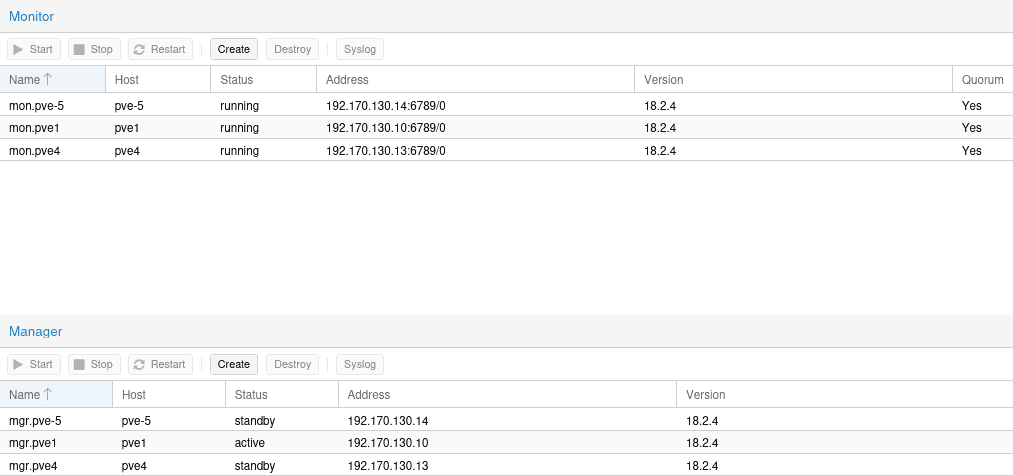
Erstellen Sie auf pve4 und pve-5 jeweils einen Monitor über die Web-GUI (Node → Ceph → Monitor → Create). Damit besteht wieder ein robustes 3-Node-Quorum.
2. Ceph OSDs erstellen
Erstellen Sie auf den neuen Nodes die OSDs auf den Ziel-Datenträgern. Sobald die ersten OSDs online sind, startet Ceph automatisch das Rebalancing & Backfilling, um die Replikation wiederherzustellen.
3. Ceph-Manager (MGR) nachziehen
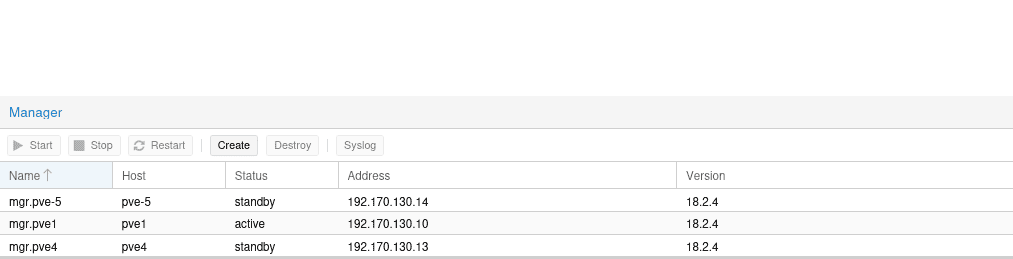
Erstellen Sie auf pve4 und pve-5 je einen Manager (Node → Ceph → Manager → Create):
4. Ceph-MDS für CephFS nachziehen
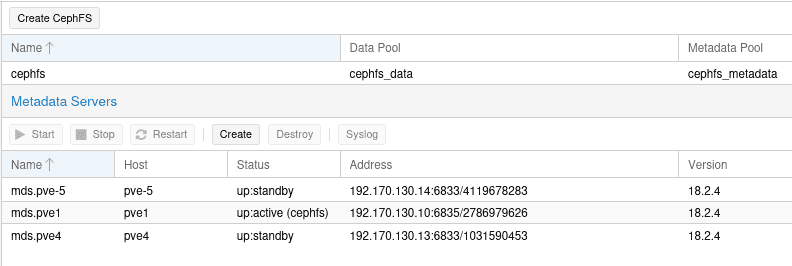
Falls CephFS verwendet wird, erstellen Sie die MDS-Dienste auf den neuen Nodes (Node → CephFS → Metadata Servers → Create):
Schritt 6: Verifikation des Gesamtsystems
Nachdem Ceph das Backfilling aller Daten abgeschlossen hat, prüfen Sie den Gesamt-Status über die Kommandozeile:
root@pve-5:~# ceph -sDie Ausgabe zeigt ein vollkommen gesundes System:
cluster:
  id:     506415a5-936e-47e7-9e2d-9c934f447407
  health: HEALTH_OK

services:
  mon: 3 daemons, quorum pve1,pve-5,pve4 (age 9m)
  mgr: pve1(active, since 69m), standbys: pve-5, pve4
  mds: 1/1 daemons up, 2 standby
  osd: 12 osds: 12 up (since 5m), 12 in (since 5m)

data:
  volumes: 1/1 healthy
  pools:   4 pools, 577 pgs
  objects: 24 objects, 593 KiB
  usage:   557 MiB used, 719 GiB / 720 GiB avail
  pgs:     577 active+clean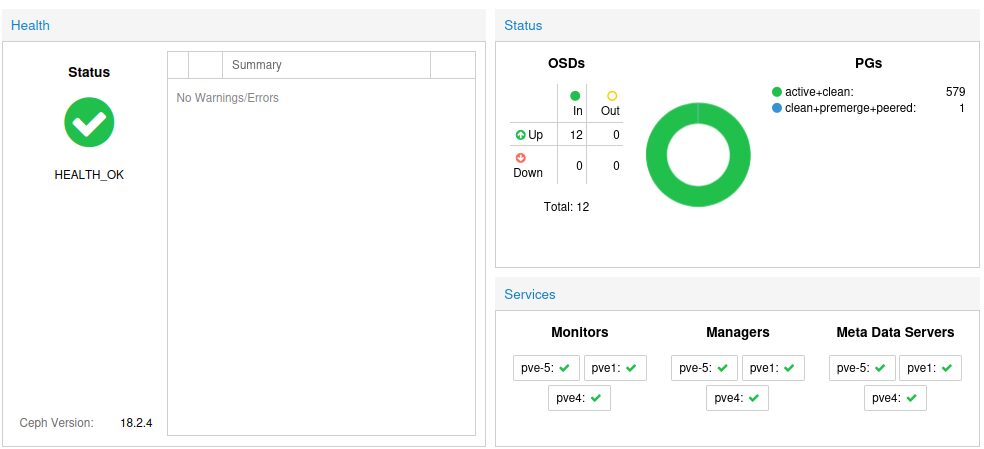
Fazit & Best Practices
Der gleichzeitige Verlust von 2 von 3 Nodes in einem Ceph-HCI-Cluster ist ein Worst-Case-Szenario, führt jedoch dank der robusten Architektur von Ceph nicht zu Datenverlust, solange mindestens ein intaktes Replikat auf dem überlebenden Node vorhanden ist. Entscheidend für ein erfolgreiches Disaster Recovery sind:
- Zuerst die Corosync-Quorum-Wiederherstellung via
pvecm expected 1. - Die manuelle Monmap-Extraktion und -Bereinigung auf Dateiebene, um das Ceph-Monitor-Quorum zu reaktivieren.
- Das vorsichtige Bereinigen verwaister OSDs, ohne gesunde OSDs zu beschädigen.
- Der schrittweise Wiederaufbau von MONs, OSDs und MGR/MDS auf neuen Hardware-Knoten.
Sie benötigen Unterstützung bei Ihrem Proxmox VE oder Ceph Cluster?
Direkter Experten-Support, Audits und zertifizierte Trainings für Ihr IT-Team.
Proxmox VE & Ceph Support
Ob akute Fehleranalyse, Disaster Recovery, Performance-Optimierung oder die ganzheitliche Absicherung Ihrer Infrastruktur: Unsere zertifizierten Spezialisten unterstützen Ihr IT-Team schnell, praxisnah und auf Augenhöhe.